Casi ocho de cada diez de los sitios de noticias más importantes del Reino Unido y EE. UU. ahora bloquean los robots de entrenamiento de IA.
Esta semana en Londres, se dijo a los editores que «nunca es demasiado tarde» para comenzar a bloquear bots debido a la frecuencia con la que se deben realizar nuevos rastreos a través de generación de recuperación aumentada para que las respuestas del chatbot de IA se mantengan actualizadas.
Alrededor del 79% de casi 100 sitios de noticias importantes del Reino Unido y EE. UU. bloquean al menos un rastreador utilizado para el entrenamiento de IA, desde GPTBot, ClaudeBot, Anthropic-ai, CCBot, Applebot-Extended y Google-Extended de OpenAI.
Mientras tanto, el 71% impide que los robots de inteligencia artificial rastreen sus sitios para recuperarlos o realizar búsquedas en vivo. Estos bots son: ChatGPT-User, Claude-Web, Perplexity-User y OAI-SearchBot.
El último análisis sobre quién bloqueó qué fue realizado por la plataforma de relaciones públicas digitales Buzzstream, analizando una lista combinada y deduplicada de los 50 principales sitios web de noticias en el Reino Unido y EE. UU., y compartida con Press Gazette.
Entre los 50 principales editores que habían bloqueado todos los robots de IA incluidos en el análisis se encontraban: BBC (tanto su dominio .co.uk como .com), The New York Times, Daily Mail, The Telegraph, Sky News, AP News, New York Post, Newsweek, NBC News, Wall Street Journal, Metro, Business Insider, ABC News, Huffpostfeed, The Hill. Esto significa que el 34% de los 50 principales bloquearon todos los bots.
Alrededor del 14% de los 50 principales editores brindaron acceso a los 11 rastreadores de IA analizados: Fox News, The Independent, GB News, Substack, Standard, Drudge Report y Politico.
El director de SEO de Telegraph, Harry Clarkson-Bennett, dijo a Buzzstream: “Los editores están bloqueando los robots de inteligencia artificial que utilizan robots.txt porque casi no hay intercambio de valor.
“Los LLM no están diseñados para enviar tráfico de referencia y los editores (todavía) necesitan tráfico para sobrevivir.
«Así que la mayoría de nosotros bloqueamos los robots de IA porque estas empresas no están dispuestas a pagar por el contenido en el que se ha entrenado su modelo, y su producción es casi enteramente interna».
Entre los 50 sitios principales analizados, Perplexity-User fue el más permitido (de 32), seguido de ChatGPT-User (24). Ambos son rastreadores de recuperación/búsqueda en vivo que determinan si Perplexity o ChatGPT pueden acceder a un sitio en tiempo real para proporcionar respuestas a las preguntas de los usuarios. Por el contrario, Perplexity-Bot aparece y enlaza a sitios web en los resultados de búsqueda de Perplexity.
El menos permitido fue el bot de entrenamiento de Anthropic (ocho), seguido por el bot de archivo web Common Crawl CCBot (nueve).
En febrero de 2024, un análisis de Press Gazette encontró que 61 de los 106 principales sitios de noticias del Reino Unido y EE. UU. bloquearon al menos un rastreador de inteligencia artificial, lo que muestra un aumento en los últimos dos años.
Google Extended «te permite decir sí a la búsqueda, no al entrenamiento de IA», dijo la semana pasada la directora senior de asuntos gubernamentales y políticas públicas de Google, Roxanne Carter, al parlamento del Reino Unido.
Google Extended permite a los editores optar por no permitir que el chatbot de IA Gemini y la plataforma de desarrollo de IA Vertex eliminen su contenido, pero no impide que se acceda a los sitios y se utilicen en las listas de IA de Google.
Para evitar esto, los editores tendrían que optar por no ser eliminados por el robot de Google, que indexa para las búsquedas. El robot de Google no se incluyó en el nuevo análisis de Buzzstream, pero excluirse se ha descrito como una «elección poco envidiable».
Buzzstream descubrió que los editores estadounidenses son «mucho más agresivos» a la hora de bloquear Google Extended (58%) que los editores del Reino Unido (29%).
Entre los 100 principales sitios de noticias de EE. UU. y el Reino Unido, los sitios estadounidenses son más estrictos en el entrenamiento de robots (81 % de bloqueo) que sus homólogos del Reino Unido (77 %).
Robots.txt no es una forma infalible de bloquear robots de IA, ya que las empresas de IA pueden ignorar sus directivas o eludirlas mediante el uso de empresas de terceros para extraer contenido.
Los errores tipográficos y las configuraciones incorrectas pueden impedir que los editores bloqueen de manera efectiva
Anthony Katsur, director general del IAB Tech Lab, dijo en el evento Techtonic del Interactive Advertising Bureau (IAB) en Londres el miércoles que habían «examinado un gran porcentaje» de los comandos de los editores a los robots de IA y descubrieron que «hay muchos errores tipográficos o mucha mala configuración del archivo robots.txt, lo que significa que podría no ser obedecido, no es que siempre se obedezca».
Katsur recomendó a los editores bloquear los robots de IA, incluso si aún no lo han hecho, debido a la generación de recuperación aumentada, lo que significa que los modelos generativos de IA recuperan y hacen referencia a nueva información de la web en tiempo real (en lugar de depender de un rastreo de descubrimiento inicial).
Katsur dijo: «Editores, si no han bloqueado y creen que es demasiado tarde para bloquear, están equivocados. Nunca es demasiado tarde para bloquear».
«Los LLM regresarán y volverán a rastrear el contenido para mantener esta información actualizada, relevante y precisa».
También dijo: «En la historia de la humanidad, nunca se ha creado un mercado en el que las cosas se regalan o simplemente se roban. Así que sin escasez, los mercados no existirán. Así que, si los editores no bloquean, es poco probable que tome forma algún tipo de mercado de contenidos».
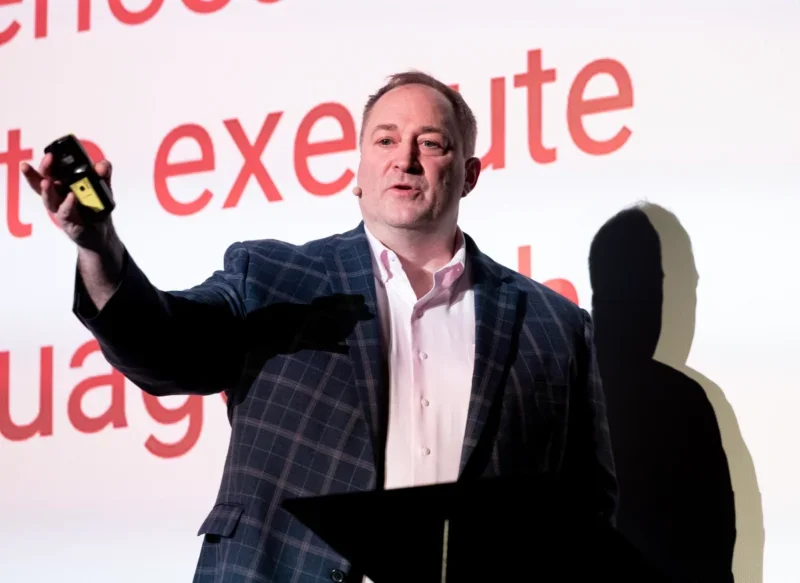
Katsur sugirió que los editores deberían «unir brazos» colectivamente y bloquear los bots «y punto», aunque sólo sea durante 72 horas, «sólo para demostrar que hay fuerza entre los editores, grandes y pequeños».
Dijo que si los editores se vieran amenazados con una demanda antimonopolio o secreta como resultado, «sería un buen problema porque significaría que todavía están en el negocio».
Katsur dijo que el IAB Tech Lab cree que los «días del rastreo» no son «sostenibles para los editores».
«Tampoco creemos necesariamente que sea sostenible para los LLM… a medida que vemos estallar la burbuja de la IA, creo que desde una perspectiva fiscal o de financiación, el fácil acceso a las compras continuas de GPU (unidades de procesamiento de gráficos) para financiar los LLM será limitado, por lo tanto, necesitará una mayor eficiencia en la forma en que se accede a los LLM y se estructura de manera más efectiva».
El IAB Tech Lab está trabajando en una iniciativa alternativa de Protocolos de Monetización de Contenido (CoMP) que, según Katsur, implicaría un «nuevo conjunto de API de código abierto que permitirá a los LLM acceder al contenido del editor o de la marca sólo bajo estrictos controles y estructuras, protegiendo así su propiedad intelectual, sus derechos de autor y, nuevamente, también proporcionando a los LLM un consumo estructurado con mayor precisión y un formato y uso más eficiente».
En un grupo de trabajo de CoMP celebrado en octubre, Google, Microsoft y Meta tomaron asiento en la mesa junto a los editores. Pero Katsur dijo que han «tenido grillos absolutos de OpenAI, Anthropic, Perplexity y algunos de los otros más pequeños».
Correo electrónico pged@pressgazette.co.uk para señalar errores, proporcionar consejos sobre historias o enviar una carta para su publicación en nuestro blog «Página de cartas»